OmniHuman 1.5
- Cliplängen
- 1–30s
- Auflösungen
- 720p
ab 140 Credits
Erstelle aus einem Porträt und deiner WAV-Aufnahme ein audiogesteuertes Avatarvideo. Prüfe Einstellungen, Credits und Mundbewegungen.
Ein einzelnes Porträt und deine fertige WAV-Aufnahme liefern Bild und Stimme. Dieser Ablauf erzeugt keine Sprache aus eingegebenem Text. Ein gut sichtbares Gesicht und sauberes Audio erleichtern die Prüfung von Mundbewegung und Ausdruck.
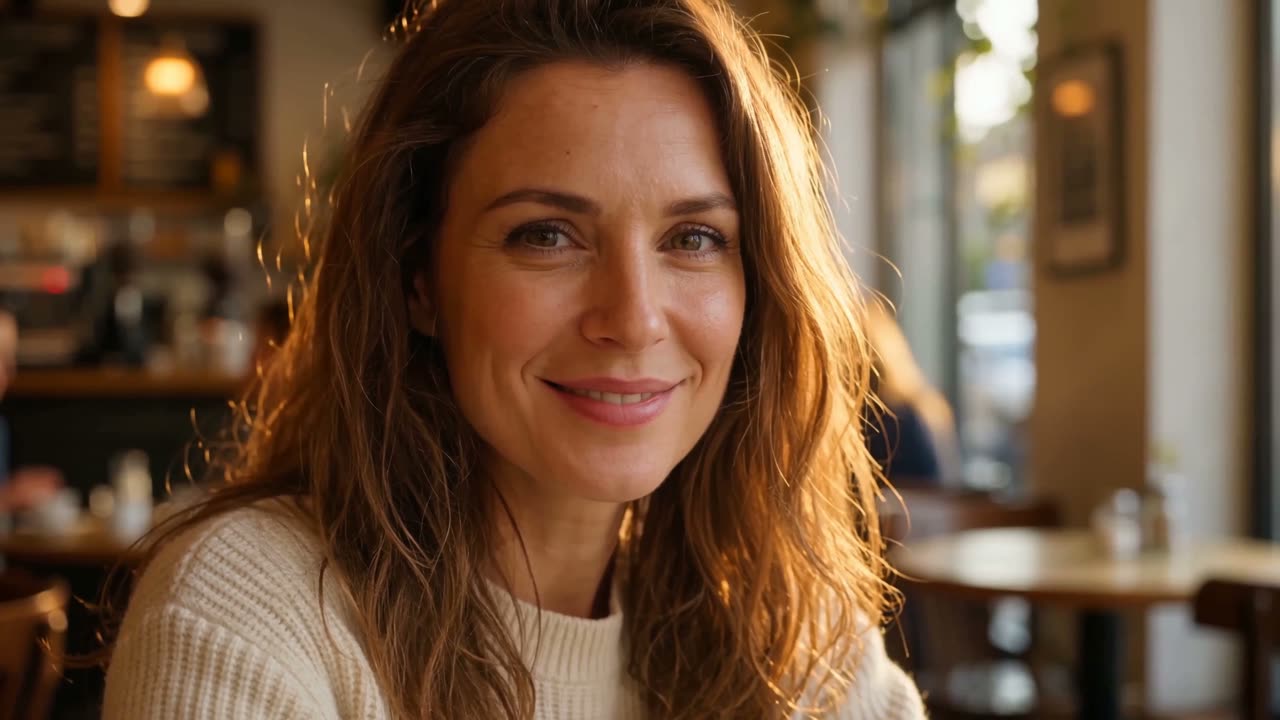
Konzeptbeispiel für eine Gestaltungsidee, kein geprüftes Ergebnis dieses Werkzeugs.
Einzelporträt + WAV-Aufnahme
Mundbewegung, Ausdruck und Audiotiming prüfen
Lade ein klares Foto einer einzelnen Person mit wenig Verdeckung hoch.
Lade auf dieser Seite eine unterstützte WAV-Datei hoch und prüfe Modell, Dauer und Credits.
Bestätige die Generierung auf dieser Seite und prüfe anschließend Ton, Mundbewegungen und Gesicht.
ab 140 Credits
Verwende eine vorbereitete Begrüßung oder persönliche Vorstellung.
Zeige eine kurze Erklärung mit bereits aufgenommenem Audio.
Teste eine vorbereitete Textzeile mit einer erfundenen Figur und freigegebenem Material.
Nein. Dieser Ablauf benötigt eine WAV-Aufnahme und enthält keine Text-zu-Sprache-Funktion.
Ein Porträt mit einer Person und eine unterstützte unkomprimierte WAV-Datei. Beachte die Modellgrenzen.
Wähle ein klares Einzelporträt. Mehrere oder verdeckte Gesichter können die Zuordnung erschweren.
Nein. Prüfe Mundbewegungen, Gesicht und Audiotiming vor dem Veröffentlichen.